在现代应用程序开发中,数据的高效存储与缓存是保障性能与可扩展性的关键。JunoDB作为一个分布式键值存储系统,为开发者提供了强大的数据存储和缓存能力,特别是在处理特定协议和双路数据处理场景下,能够提供可靠的数据处理和存储支持服务。本文将探讨如何利用JunoDB实现高效的数据存储与缓存,并解析其在协议和数据服务方面的优势。
一、JunoDB简介
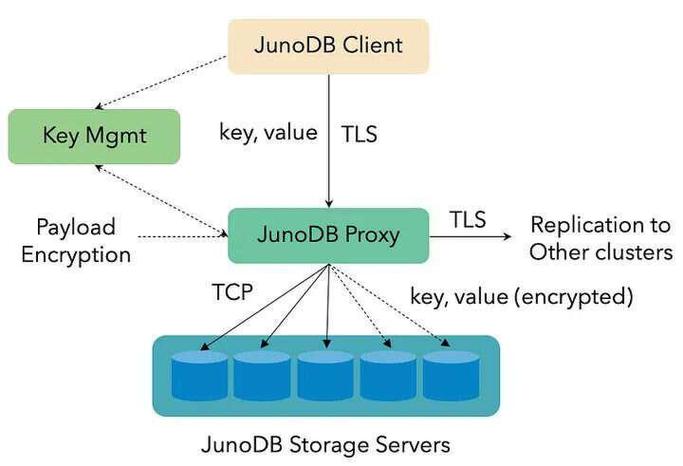
JunoDB是一个开源的分布式键值存储系统,专为高吞吐量和低延迟场景设计。它支持水平扩展,能够自动分片数据,并提供强一致性或最终一致性选项。JunoDB的核心优势在于其灵活的架构,使其既能作为持久化存储,也能作为缓存层使用。应用程序可以通过简单的API调用,将数据存储到JunoDB中,并利用其内置的缓存机制加速数据访问。
二、协议支持与数据处理
在题目中提到的“的协议和两 数据处理”,可能指的是某种特定的网络协议(如HTTP/2、gRPC)以及双路(dual-path)数据处理模式。JunoDB本身并不直接限定协议,而是通过客户端库和API与应用程序交互。但应用程序可以通过适配层,将JunoDB集成到支持特定协议的服务中。例如:
- 协议适配:JunoDB的客户端支持多种语言(Java、Go、Python等),应用程序可以基于gRPC或RESTful API封装JunoDB操作,从而实现与前端协议的无缝对接。
- 双路数据处理:JunoDB可用于同时处理实时数据流(如缓存)和批量数据(如持久化存储)。例如,写请求可以先写入缓存层,再异步同步到持久层;读请求则优先从缓存获取,未命中时回源到存储。这种双路模式显著提升了数据处理效率。
三、数据处理和存储支持服务
JunoDB提供了一整套数据处理和存储支持服务,主要包括:
- 数据分片与复制:自动将数据分布到多个节点,支持多副本,确保高可用性和容错性。
- 缓存策略:支持TTL(生存时间)设置,可自动过期数据,适用于缓存场景。同时支持LRU等淘汰策略,优化内存使用。
- 事务与一致性:提供原子操作和条件更新,保证数据一致性。对于需要强一致性的场景,可配置写多数派确认。
- 监控与管理:内置指标采集和健康检查,方便运维人员监控存储和缓存状态。
四、应用场景示例
假设一个电商平台需要处理用户会话数据和商品库存信息。可以使用JunoDB:
- 将会话数据存储在JunoDB中,设置TTL为30分钟,作为缓存层,减少数据库压力。
- 商品库存数据则持久化存储,并利用JunoDB的原子递减操作保证并发安全。
- 通过gRPC协议,前端服务与JunoDB交互,实现快速读写。
- 利用双路数据处理,实时更新缓存并异步持久化库存变更。
五、
JunoDB凭借其分布式架构和灵活的API,为应用程序提供了高效的数据存储与缓存解决方案。通过合理的协议适配和双路数据处理设计,开发者可以构建出高性能、可扩展的数据服务。无论是作为缓存还是持久化存储,JunoDB都能胜任,并助力企业在数据处理和存储支持服务方面达到新的高度。随着JunoDB社区的持续发展,其功能和性能将进一步完善,成为更多应用的首选存储中间件。