引言
随着企业数据规模呈指数级增长,传统数据仓库在存储成本、扩展性和数据类型支持上的局限日益凸显。云原生数据湖凭借对象存储的弹性、开放格式的兼容性以及计算存储分离的架构,成为承载海量多源异构数据的核心基础设施。数据湖若缺乏有效的元数据管理,极易退化为“数据沼泽”。元数据管理技术不仅关乎数据发现与治理,更直接影响数据处理与存储支持服务的效率与可靠性。本文将从云原生数据湖的元数据管理架构出发,深入解析其关键技术,并探讨元数据如何赋能数据处理与存储支持服务。
一、云原生数据湖元数据管理的核心挑战
云原生数据湖通常构建在Amazon S3、阿里云OSS、Azure Blob Storage等对象存储之上,计算引擎(如Spark、Presto、Flink)与存储层解耦。这种架构带来三个关键元数据挑战:
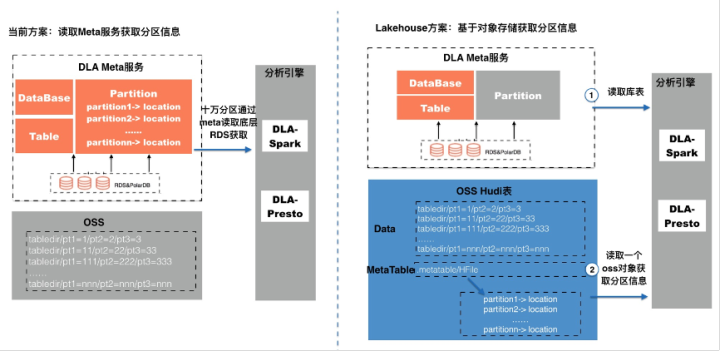
- 文件级元数据爆炸:对象存储以扁平结构管理海量文件,单表可能包含数百万个小文件元数据,传统Hive Metastore难以支撑。
- 多引擎元数据一致性:不同计算引擎对表结构、分区、统计信息的理解需要统一视图,否则出现“同一份数据、不同查询结果”。
- 事务与并发控制:数据湖需要支持ACID语义,元数据层必须实现快照隔离、乐观并发控制,同时避免对象存储的最终一致性带来的隐患。
二、云原生元数据管理关键技术
2.1 开放表格式:Iceberg、Hudi与Delta Lake
开放表格式通过在数据文件之上维护一层元数据清单(Manifest)和快照(Snapshot),将表级元数据与文件级元数据分离。以Apache Iceberg为例,其元数据树如下:
- 表元数据文件(Table Metadata):记录表结构、分区规格、快照列表。
- 清单列表(Manifest List):描述每个快照包含的清单文件。
- 清单文件(Manifest):记录数据文件的路径、分区、列统计信息。
这种分级结构使元数据可扩展至数十亿文件,并支持时间旅行、增量读取。Hudi通过时间线(Timeline)和文件组(File Group)实现类似能力,Delta Lake则依赖事务日志(deltalog)。
2.2 统一元数据服务:从Hive Metastore到云原生Catalog
传统Hive Metastore基于关系数据库,在云原生场景下成为瓶颈。新一代元数据服务如AWS Glue Data Catalog、Unity Catalog、Apache Polaris采用无状态服务+分布式存储架构,提供:
- 多租户与细粒度权限:表、列、行级访问控制。
- 跨引擎共享:Spark、Trino、Flink、Presto通过Thrift或REST接口访问同一Catalog。
- 自动元数据发现:爬取对象存储路径,自动推断Schema与分区。
2.3 元数据存储与索引优化
元数据本身也需要高效存储。常见方案包括:
- 键值存储:如RocksDB、FoundationDB,用于高并发点查。
- 列式存储:将清单文件以Parquet格式存储,利用谓词下推加速分区裁剪。
- 分布式缓存:在计算节点缓存热元数据,减少对中心Catalog的请求压力。
三、元数据管理如何支持数据处理服务
数据处理服务依赖元数据实现三大能力:
3.1 查询加速与分区裁剪
当Spark或Trino执行查询时,元数据层的分区统计信息(如min/max值、空值计数)使引擎能够跳过不相关的数据文件。例如,Iceberg的清单文件内嵌列级统计,可将扫描数据量降低一个数量级。
3.2 流批一体与增量处理
元数据快照机制支持增量读取:Flink或Spark Structured Streaming可基于快照ID读取新增数据,无需扫描全表。Hudi的增量视图和Delta Lake的Change Data Feed均依赖元数据记录变更历史。
3.3 多引擎协同与数据虚拟化
统一元数据服务使不同引擎共享同一张表的Schema与权限。例如,数据工程师用Spark写入Iceberg表,BI分析师用Trino查询,机器学习工程师用PyTorch读取——所有引擎看到相同的元数据视图,消除数据孤岛。
四、元数据管理如何支持存储支持服务
存储支持服务关注数据生命周期、成本与可靠性,元数据是其决策依据:
4.1 生命周期管理与分层存储
基于元数据中的访问时间、文件大小、分区年龄,可自动执行:
- 冷热分层:将30天未访问的分区从标准存储迁移至低频/归档存储。
- 小文件合并:识别小文件密集分区,触发Compaction,降低NameNode压力与存储开销。
- 过期快照清理:删除不再引用的旧快照及其数据文件,回收存储空间。
4.2 数据血缘与合规审计
元数据记录数据来源、转换过程与去向,形成血缘图谱。在存储支持服务中,血缘用于:
- 影响分析:上游表变更时,快速定位下游受影响任务。
- 合规审计:满足GDPR、CCPA等法规对数据删除与追溯的要求。
4.3 存储优化与成本洞察
通过元数据统计(表大小、分区数量、文件数量、冗余副本),存储服务可生成成本报告,并推荐优化策略,如调整分区策略、启用Z-Order排序以提升查询效率。
五、典型架构与实践建议
一个典型的云原生数据湖元数据管理架构包含:
- 存储层:对象存储 + 开放表格式文件。
- 元数据层:统一Catalog服务(如Unity Catalog)+ 分布式元数据存储(如JanusGraph用于血缘)。
- 计算层:Spark、Trino、Flink等引擎通过连接器访问Catalog。
- 服务层:数据处理服务(ETL、查询、流处理)与存储支持服务(生命周期、血缘、成本)均调用元数据API。
实践建议:
- 优先选用Iceberg或Delta Lake等开放表格式,避免厂商锁定。
- 部署统一元数据服务,而非每个引擎独立维护Metastore。
- 启用元数据自动统计与缓存,减少对中心服务的压力。
- 将元数据纳入数据治理体系,实施细粒度权限与审计。
六、与展望
云原生数据湖的元数据管理已从简单的Hive Metastore演变为支撑数据处理与存储支持服务的核心中枢。通过开放表格式、统一Catalog、分布式元数据存储,企业能够在海量数据上实现高效查询、增量处理、自动分层与合规治理。随着AI与大数据融合,元数据将更进一步赋能智能索引、自动优化与语义搜索,使数据湖真正成为“自驱动”的数据平台。
对于技术团队而言,深入理解元数据管理技术,不仅是构建数据湖的基础,更是释放数据处理与存储支持服务价值的关键。